
CPUだけの時代から、CPU+GPU+DPUへ
AI時代のコンピューティングを支える「第3のプロセッサ」とHSC-5360
生成AIやエッジAI、5G、クラウドサービスの普及によって、コンピューターが処理するデータ量は急速に増えています。
その裏側では、プロセッサの役割分担にも大きな変化が起きています。
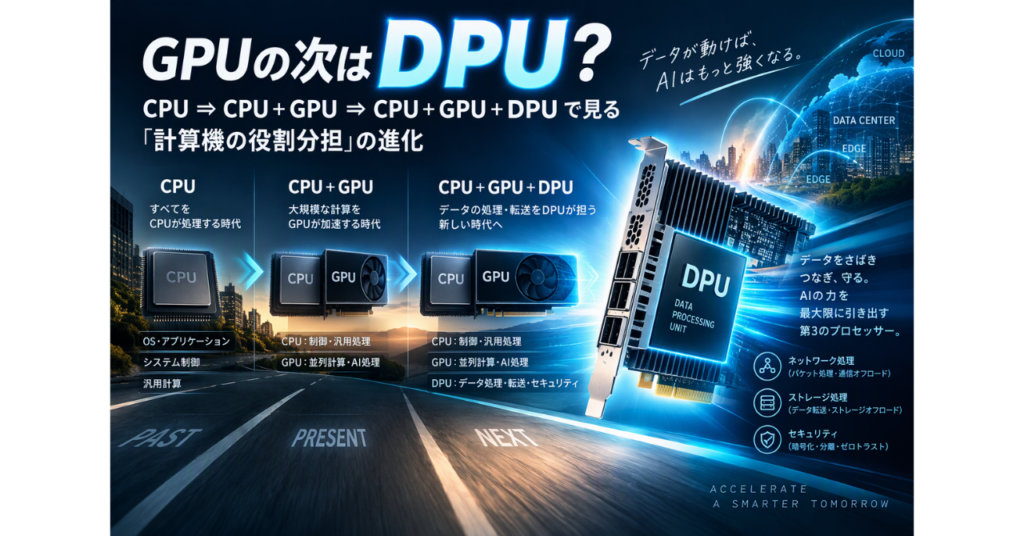
CPUですべてを処理する時代から、CPU+GPU、そしてCPU+GPU+DPUへ。
なぜプロセッサは増えているのでしょうか。
答えは、「CPUが遅くなったから」ではありません。
むしろ、CPU、GPU、DPUそれぞれが得意な仕事を担当した方が、システム全体を高速かつ効率的に動かせるからです。実際、DPUはネットワーク、ストレージ、セキュリティなどのインフラ処理をCPUからオフロードするプロセッサとして位置付けられています。
1. まずは「CPUだけ」の時代
CPU(Central Processing Unit)は、コンピューター全体を取り仕切る、いわば「司令塔」です。
OSを動かす、アプリケーションを実行する、条件分岐をおこなう、各デバイスを制御する。
高い汎用性を持ち、複雑な逐次処理にも適していることから、長い間コンピューターの中心的な演算装置を担ってきました。
ところが、扱うデータ量が巨大になってくると、何でもCPUに任せる方式には限界が見えてきます。
たとえばAIで必要になる、
「同じような計算を、膨大なデータに対して一斉に実行する」
という仕事は、CPUの得意分野とは少し違います。
そこで存在感を増したのがGPUです。
2. CPU+GPUへ
「何でもCPU」から「得意なプロセッサに任せる」時代へ
GPU(Graphics Processing Unit)は、その名前の通り、もともとは画像処理を高速化するために発展したプロセッサです。
CPUが複雑な処理を柔軟に実行することを得意とするのに対して、GPUは多数の演算器を使って、同種の演算を大量に並列実行することを得意とします。
この性格が、ニューラルネットワークで大量に発生する行列演算と非常に相性がよく、現在では画像処理だけでなくAIの学習・推論、HPC、科学技術計算などで重要な役割を担うようになりました。
つまり、
CPU → 制御・汎用処理
GPU → 大規模な並列演算
という役割分担です。
これによってCPU単独よりはるかに大きな計算能力を実現できるようになりました。
しかし、AIシステムがさらに大規模になると、今度は別の問題が目立ってきます。
「計算する」だけではなく、「データを運ぶ」仕事が膨大になってきたのです。
3. そしてCPU+GPU+DPUへ
次のボトルネックは「データを運び、さばく」こと
高速なGPUを搭載しても、演算に必要なデータがGPUまで届かなければ、その性能を十分に発揮できません。
ネットワーク通信、ストレージアクセス、パケット処理、暗号化、仮想化など、CPUにはアプリケーションそのもの以外にも多くの仕事があります。
こうしたインフラ側のデータ処理をCPUから引き受けるのがDPU(Data Processing Unit)です。DPUはネットワークインターフェース、CPUコア、各種アクセラレーションエンジンを組み合わせ、ネットワークやストレージ、セキュリティなどの処理をオフロードできるよう設計されています。
非常に単純化すると、3者の関係はこう表せます。
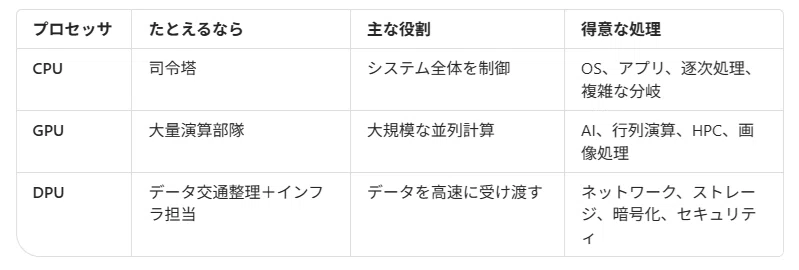
DPUの発想で重要なのは、CPUやGPUを置き換えるものではないという点です。
CPUにはCPUの仕事を。
GPUにはGPUの仕事を。
DPUにはDPUの仕事を。
それぞれに「得意な仕事だけをさせる」ことで、システム全体の効率を高めようという考え方です。NVIDIAも現在のDPUを、CPUによる汎用コンピューティング、GPUによるアクセラレーテッドコンピューティングと並ぶデータセンターの主要な構成要素として説明しています。
4. 一言で表すと
この変化を整理すると、次のようになります。
第1世代:CPU
「計算も制御もデータ処理も、とにかくCPUが担当」
↓
第2世代:CPU + GPU
「大量の計算はGPUへ」
↓
第3世代:CPU + GPU + DPU
「大量の計算はGPUへ。大量のデータ処理はDPUへ。そしてCPUは本来の仕事へ」
つまり、単純な「CPUの高速化」から、
ワークロードごとに最適なプロセッサへ仕事を振り分ける
という方向へコンピューティングアーキテクチャそのものが変化していると見ることができます。
5. そこで登場するDPUカード「HSC-5360」
こうしたCPU・GPU・DPUによるヘテロジニアスコンピューティングを実装する選択肢の一つが、CASOのHSC-5360です。
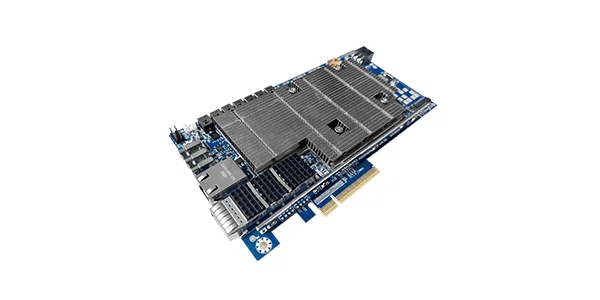
HSC-5360は、Marvell OCTEON 10のCN106XXを採用したDPUカードです。最大24コアのArm Neoverse N2、DDR5、PCIe 5.0、高速ネットワークインターフェースなどを搭載し、AIデータ処理やRANオフロードなどを想定しています。
主な仕様
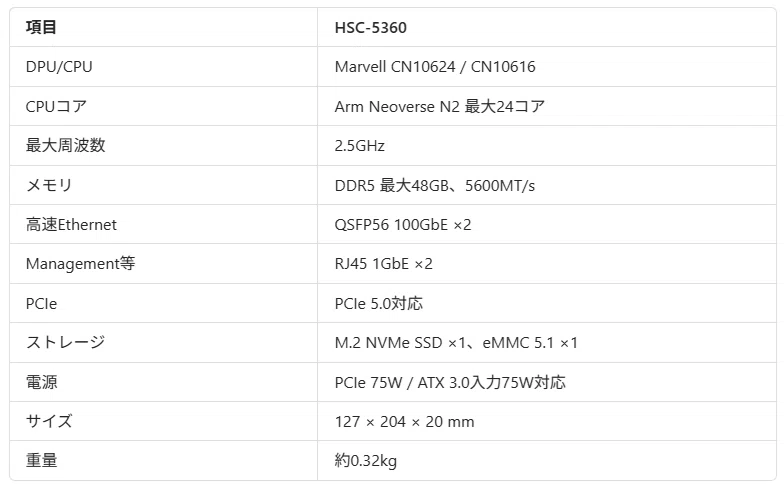
特に注目したいのは、単なる「高速NIC」ではなく、Arm CPUコアと高速I/O、各種ハードウェアアクセラレーションを組み合わせたデータ処理基盤になっているところです。
前世代OCTEON比で3倍の演算性能と50%の低消費電力、インラインML/AIハードウェアアクセラレータによるソフトウェアベース推論比100倍、VPPベースのハードウェアアクセラレータによる5倍以上のパケット処理速度で、56G SerDesなどを利用し、400Gを超えるデータパスをサポートしています。
※ 実際の性能はワークロード、ソフトウェア、システム構成等によって異なる点には注意が必要です。
6. DPUを入れると何が変わるのか
CPU+GPUのAIサーバーを例に考えてみます。
GPUが高速にAI推論を処理できても、その前後では大量のデータ転送が発生します。
ネットワーク
↓
CPU
↓
GPU
↓
CPU
↓
ネットワーク
この経路でネットワーク、暗号化、ストレージ、仮想化などの処理までCPUが引き受ければ、CPU時間やメモリ帯域を消費します。
そこでDPUを利用して、
DPU:データを受け取り、処理し、必要な場所へ流す
GPU:受け取ったデータを高速演算する
CPU:アプリケーションやシステム全体を制御する
という分業をおこないます。
NVIDIAのBlueFieldでも同じ思想が採られており、ネットワーク、ストレージ、サイバーセキュリティなどのインフラ処理をDPU側へオフロードすることで、CPUコアを本来のワークロードへ戻すアプローチが取られています。
7. エッジAIや5GでDPUが面白くなる理由
HSC-5360で特に興味深いのが、データセンターだけでなく、4G/5G RANやvRAN、エッジからクラウドまでを想定している点です。
エッジでは、
- 大量のネットワークパケットを受信する
- 前処理する
- AIで推論する
- 結果をリアルタイムに返す
- 通信を暗号化する
といった異なる種類の処理が同時に要求されます。
この場合に、
CPU = 制御
GPU / AIアクセラレータ = AI演算
DPU = 通信・データ処理
という役割分担ができれば、それぞれのプロセッサをより本来の処理へ集中させられます。
HSC-5360の活用例として、PCI ExpressスロットにDPU / SmartNICを搭載したエッジAIコンピューティングや、Xilinx Alveo V70を組み合わせたビデオ分析・自然言語処理などのAI推論などがあります。
8. DPUは「新しいCPU」ではない
DPUを理解するときに、一番重要なのはここかもしれません。
DPUは、
CPUより速いCPUではありません。
GPUの代わりになるものでもありません。
コンピューターを、
「何でも一つのプロセッサで処理する機械」から、「処理の性質に合わせて専門家へ分業する機械」に変えるためのプロセッサ
と考えると、その役割が分かりやすくなります。
CPUが「考える」
GPUが「大量に計算する」
DPUが「データをさばき、届け、守る」
この3つが協調することによって、AI時代のコンピューティング基盤が構成されていくわけです。現在のAIデータセンターでもCPU、GPU、DPUを組み合わせる構成が実際に採用されており、たとえばNVIDIA DGX B200はBlackwell GPUに加えBlueField-3 DPUを搭載しています。
まとめ
「演算性能」だけではなく「データをどう動かすか」の時代へ
コンピューティングの進化を振り返ると、
CPU
↓
CPU + GPU
↓
CPU + GPU + DPU
という流れは、単にプロセッサの種類が増えたという話ではありません。
CPU:汎用処理とシステム制御
GPU:大規模な並列演算
DPU:ネットワーク、ストレージ、セキュリティを中心とするデータ処理
という、「適材適所のコンピューティング」への変化と捉える方が本質的でしょう。
AIモデルが巨大化するほど、「どれだけ速く計算できるか」だけではなく、「その計算に必要なデータを、どれだけ高速かつ効率よく供給できるか」もシステム性能を左右します。
その意味でDPUは、GPUに続く「もう一つのアクセラレータ」というより、
CPUやGPUを本来の仕事に集中させるための、インフラ側のプロセッサ
と捉えると、その存在意義が見えてきます。
そしてHSC-5360は、Marvell OCTEON 10、最大24コアArm Neoverse N2、DDR5、100GbE、PCIe 5.0といった構成によって、その考え方をエッジAIや5G/vRANなどの領域へ展開するためのDPUカードの一例と言えます。